Deep Learning aplicado a radiografias de tórax
Há algum tempo venho tentando aproximar duas coisas que ocupam bastante a minha cabeça: aprendizado profundo e problemas reais da área da saúde. Eu já tinha estudado redes neurais, convoluções e PyTorch separadamente, mas sentia que os conceitos ainda estavam organizados como capítulos de um livro. Faltava colocá-los juntos em um problema no qual as decisões realmente tivessem consequências.
Foi assim que cheguei às radiografias de tórax.
No começo, parecia um projeto bastante direto: carregar as imagens, escolher uma CNN, treinar e medir o resultado. Depois de algumas horas lendo sobre o problema e desenhando o pipeline no caderno, percebi que eu estava começando pela parte mais confortável. Escolher uma ResNet é fácil. Difícil é responder se os dados estão separados corretamente, se as classes raras estão sendo ignoradas e se a métrica que subiu significa alguma coisa.
Este post é um diário dessa exploração. Não é um relato de um modelo pronto para ser usado por médicos e também não contém resultados clínicos. É meu caderno de estudo transformado em texto: as perguntas que apareceram, as decisões que precisei tomar e o código que organizei para que o experimento possa ser reproduzido.
Meu roteiro acabou ficando assim:
- Entender a diferença entre classificação multiclasse e multirrótulo
- Conhecer os dados antes de tocar na arquitetura
- Separar treino e validação por paciente
- Construir o
Datasete inspecionar as transformações - Lidar com o desequilíbrio das patologias
- Usar transfer learning com ResNet18
- Treinar sem perder a capacidade de reproduzir o experimento
- Avaliar cada patologia e estudar os erros
Domingo, 14/09/2026: entendendo o que o modelo deve responder
Minha primeira anotação foi uma pergunta aparentemente simples: o modelo deve escolher uma doença ou pode indicar várias?
Uma radiografia pode apresentar mais de uma alteração ao mesmo tempo. Um paciente pode ter, por exemplo, derrame pleural e atelectasia na mesma imagem. Por isso, não estamos diante de uma classificação multiclasse, na qual apenas uma opção pode ser escolhida, mas de uma classificação multirrótulo.
Para cada imagem, o modelo produz um valor para cada patologia:
1
2
imagem -> [atelectasia, cardiomegalia, edema, pneumonia, ...]
          [    0.82,          0.07,  0.31,      0.12, ...]
Cada saída é tratada como uma probabilidade independente depois da aplicação da função sigmoide. Isso também muda a função de perda: em vez de CrossEntropyLoss, usaremos BCEWithLogitsLoss.
Eu precisei parar nessa diferença por um tempo porque ela afeta quase tudo. A última camada não devolve uma única classe. Ela devolve um vetor com uma posição para cada patologia. O alvo também é um vetor de zeros e uns, e a avaliação precisa acontecer classe por classe.
Supondo um CSV com o nome da imagem, o identificador do paciente e uma coluna binária para cada condição, podemos separar os rótulos assim:
1
2
3
4
5
6
7
8
9
10
11
12
import pandas as pd
import numpy as np

train_df = pd.read_csv("data/train.csv")

non_label_columns = {"Image", "PatientId"}
label_columns = [
    column for column in train_df.columns
    if column not in non_label_columns
]

print(train_df[label_columns].sum().sort_values())
Essa contagem simples já revela uma característica central dos dados médicos: algumas condições aparecem centenas de vezes, enquanto outras possuem poucos exemplos positivos.
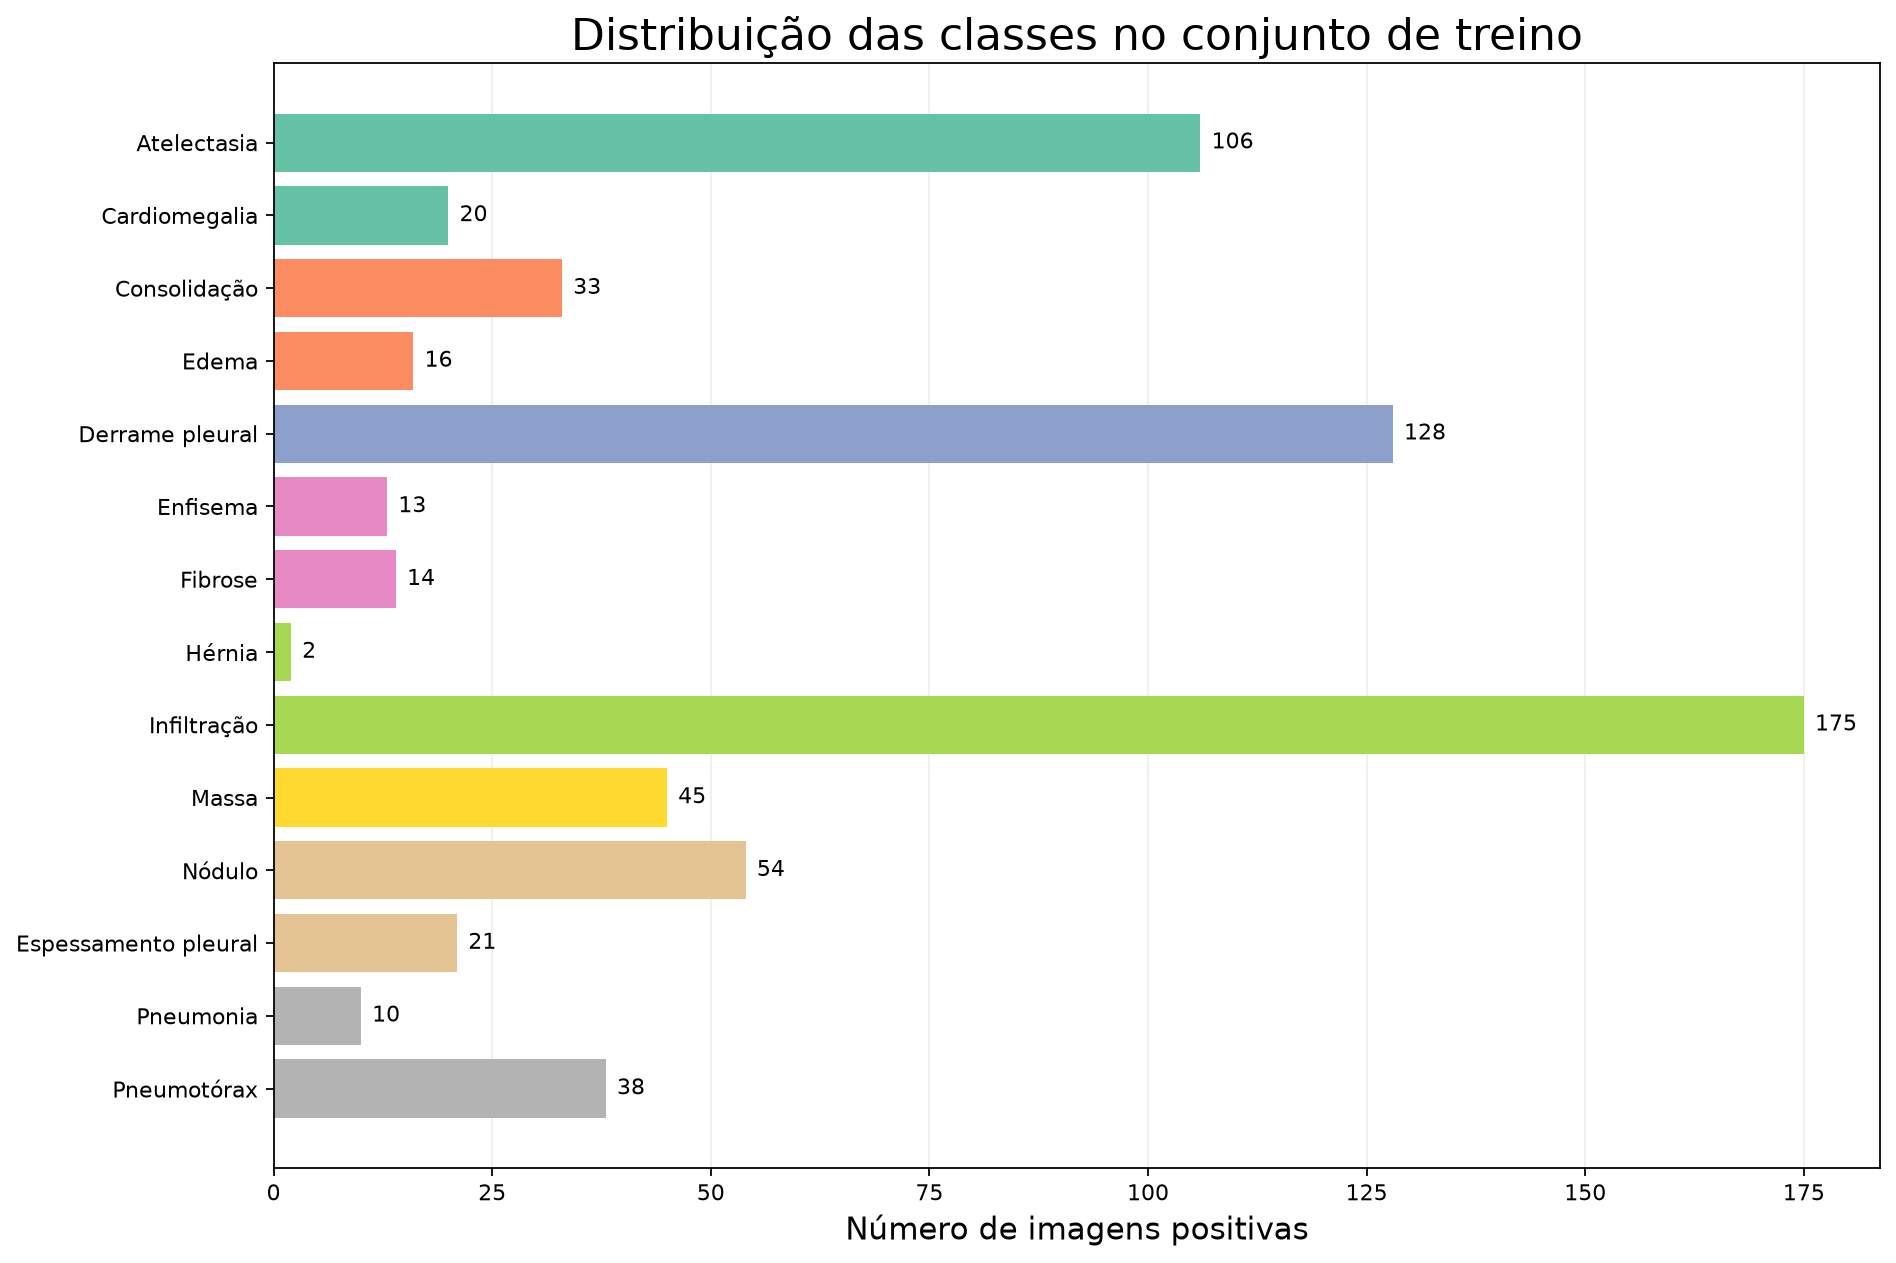 Figura 1: quantidade de exemplos positivos por patologia em uma amostra de 1.000 imagens. Uma mesma imagem pode possuir mais de um rótulo.
Eu também quis registrar três perguntas antes de prosseguir:
- Quantas imagens existem para cada paciente?
- Existem rótulos ausentes ou incertos?
- Alguma patologia possui tão poucos exemplos que a métrica ficará instável?
1
2
3
4
5
images_per_patient = train_df.groupby("PatientId").size()

print(images_per_patient.describe())
print("Rótulos ausentes:")
print(train_df[label_columns].isna().sum())
Essa etapa parece simples, mas mudou minha forma de olhar o projeto. O CSV deixou de ser apenas uma tabela que alimentaria a rede e passou a ser parte da definição do problema. Antes de pensar em desempenho, eu precisava entender de onde os rótulos vieram e o que exatamente um valor positivo representava.
Segunda-feira, 15/09/2026: vazamento de dados
Uma pessoa pode possuir várias radiografias no conjunto de dados. Se separarmos as linhas aleatoriamente, imagens do mesmo paciente podem aparecer no treino e na validação.
Isso é vazamento de dados. O modelo pode reconhecer características específicas daquele paciente, do exame ou do equipamento e parecer melhor do que realmente é quando encontra pessoas novas.
Foi um daqueles momentos em que um detalhe pequeno reorganiza o projeto inteiro. Até então, eu pensava na imagem como a unidade básica do conjunto. Mas a unidade que precisava ser isolada era o paciente. Se eu ignorasse isso, poderia passar dias ajustando um modelo e comemorando uma validação contaminada.
Uma forma simples de evitar isso é dividir os grupos de pacientes, e não as imagens:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
from sklearn.model_selection import GroupShuffleSplit

splitter = GroupShuffleSplit(
    n_splits=1,
    test_size=0.20,
    random_state=42,
)

train_idx, valid_idx = next(
    splitter.split(
        train_df,
        groups=train_df["PatientId"],
    )
)

df_train = train_df.iloc[train_idx].reset_index(drop=True)
df_valid = train_df.iloc[valid_idx].reset_index(drop=True)

overlap = set(df_train["PatientId"]) & set(df_valid["PatientId"])
assert not overlap, f"Pacientes presentes nos dois conjuntos: {overlap}"
Em um projeto real, eu manteria ainda um conjunto de teste completamente isolado e, se possível, dados externos de outra instituição. A validação interna responde se o modelo generaliza para a mesma origem dos dados; ela não garante que o comportamento será o mesmo em outro hospital.
Depois da divisão, salvei os IDs e as proporções de cada subconjunto. Parece excesso de zelo, mas isso ajuda a reconstruir o experimento e evita que uma nova execução produza uma divisão silenciosamente diferente.
1
2
3
4
5
6
7
df_train.to_csv("data/splits/train.csv", index=False)
df_valid.to_csv("data/splits/valid.csv", index=False)

print(f"Treino: {len(df_train)} imagens")
print(f"Validação: {len(df_valid)} imagens")
print(f"Pacientes no treino: {df_train['PatientId'].nunique()}")
print(f"Pacientes na validação: {df_valid['PatientId'].nunique()}")
Terça-feira, 16/09/2026: fazendo as imagens chegarem ao modelo
O Dataset precisa carregar a imagem e devolver um vetor com todos os rótulos. Como modelos pré-treinados normalmente esperam três canais, a radiografia em escala de cinza é convertida para RGB.
Essa foi a primeira parte em que senti que o projeto começou a ganhar forma. Até aqui eu estava investigando tabelas; agora conseguia pedir um item do conjunto e receber exatamente o que a rede veria: um tensor de imagem e um vetor de rótulos.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
from pathlib import Path

import torch
from PIL import Image
from torch.utils.data import Dataset


class ChestXRayDataset(Dataset):
    def __init__(self, dataframe, image_dir, labels, transform=None):
        self.dataframe = dataframe.reset_index(drop=True)
        self.image_dir = Path(image_dir)
        self.labels = labels
        self.transform = transform

    def __len__(self):
        return len(self.dataframe)

    def __getitem__(self, index):
        row = self.dataframe.iloc[index]
        image = Image.open(self.image_dir / row["Image"]).convert("RGB")
        target = torch.tensor(
            row[self.labels].to_numpy(dtype="float32"),
            dtype=torch.float32,
        )

        if self.transform:
            image = self.transform(image)

        return image, target
As transformações de treino podem introduzir pequenas variações para reduzir overfitting. Na validação, usamos apenas operações determinísticas:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
from torchvision import transforms

imagenet_mean = [0.485, 0.456, 0.406]
imagenet_std = [0.229, 0.224, 0.225]

train_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomRotation(degrees=7),
    transforms.RandomAffine(
        degrees=0,
        translate=(0.03, 0.03),
        scale=(0.95, 1.05),
    ),
    transforms.ToTensor(),
    transforms.Normalize(imagenet_mean, imagenet_std),
])

valid_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(imagenet_mean, imagenet_std),
])
Aqui é preciso ter cuidado. Aumento de dados não deve criar imagens anatomicamente implausíveis. Transformações agressivas podem remover justamente os sinais que queremos aprender. Também vale investigar se uma inversão horizontal faz sentido para o problema, porque a lateralidade pode carregar informação clínica.
Depois de aplicar o redimensionamento, uma rotação de 7 graus e a normalização, inspecionei novamente a imagem. O intervalo da barra lateral mudou porque os pixels deixaram de estar apenas entre 0 e 1. Após a normalização, eles passam a representar quantos desvios cada valor está da média usada no pré-processamento.
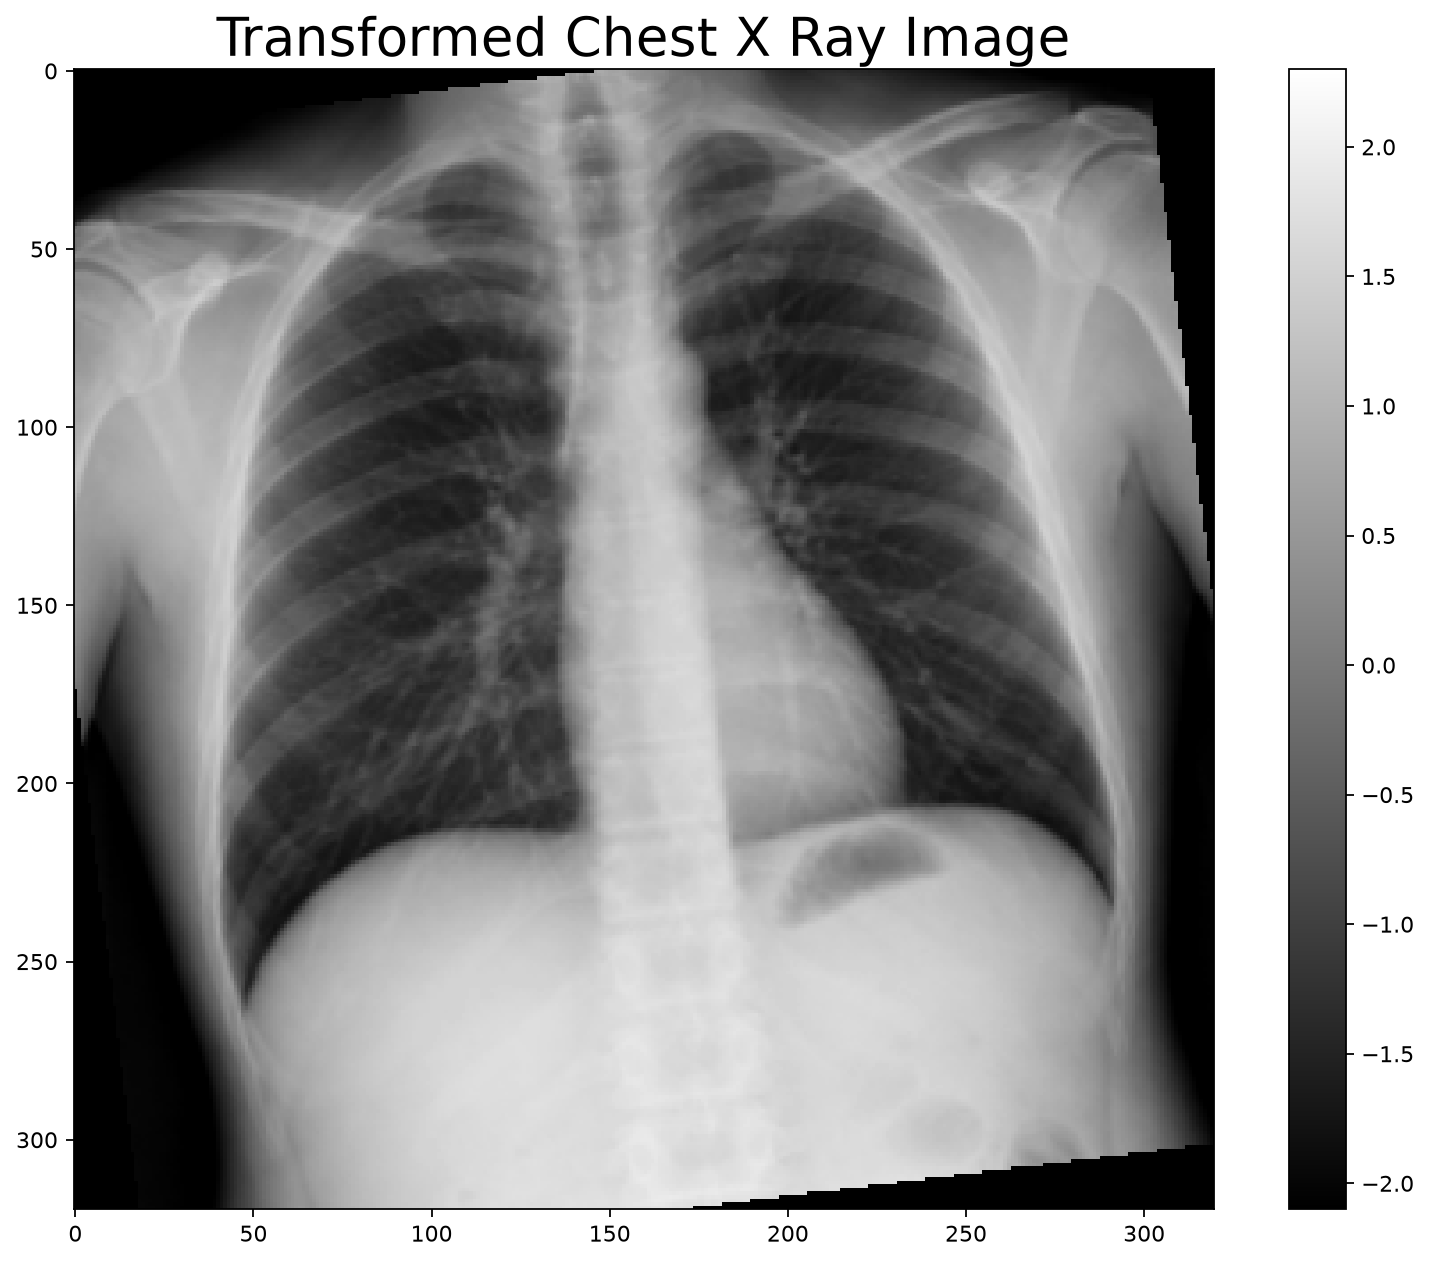 Figura 2: a mesma radiografia sintética após as transformações usadas como exemplo no pipeline de treinamento.
Antes de treinar, eu gosto de visualizar um pequeno lote depois das transformações. Essa checagem encontra erros que não aparecem na forma do tensor: contraste estranho, cortes excessivos, rotações artificiais ou até imagens associadas ao rótulo errado.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import matplotlib.pyplot as plt

dataset_preview = ChestXRayDataset(
    df_train,
    image_dir="data/images",
    labels=label_columns,
    transform=train_transform,
)

figure, axes = plt.subplots(2, 4, figsize=(12, 6))

for index, axis in enumerate(axes.flat):
    image, target = dataset_preview[index]
    image = image.permute(1, 2, 0).numpy()
    image = image * np.array(imagenet_std) + np.array(imagenet_mean)

    axis.imshow(np.clip(image, 0, 1), cmap="gray")
    axis.set_title(f"Rótulos positivos: {int(target.sum())}")
    axis.axis("off")

plt.tight_layout()
plt.show()
Só depois dessa inspeção montei os carregadores. Para a validação, shuffle=False deixa a ordem previsível e facilita relacionar uma previsão à linha original.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
from torch.utils.data import DataLoader

train_dataset = ChestXRayDataset(
    df_train, "data/images", label_columns, train_transform
)
valid_dataset = ChestXRayDataset(
    df_valid, "data/images", label_columns, valid_transform
)

train_loader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True,
    num_workers=4,
    pin_memory=True,
)
valid_loader = DataLoader(
    valid_dataset,
    batch_size=32,
    shuffle=False,
    num_workers=4,
    pin_memory=True,
)
Quarta-feira, 17/09/2026: acurácia
Imagine um conjunto no qual 98% das imagens não apresentam determinada patologia. Um classificador que sempre responde “ausente” alcança 98% de acurácia, embora seja completamente inútil para encontrar casos positivos.
Podemos aumentar a contribuição das amostras positivas usando o parâmetro pos_weight da BCEWithLogitsLoss:
1
2
3
4
5
6
7
8
9
10
11
12
13
import numpy as np
import torch
import torch.nn as nn

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

positive_count = df_train[label_columns].sum(axis=0).to_numpy()
negative_count = len(df_train) - positive_count

pos_weight = negative_count / np.clip(positive_count, a_min=1, a_max=None)
pos_weight = torch.tensor(pos_weight, dtype=torch.float32, device=device)

criterion = nn.BCEWithLogitsLoss(pos_weight=pos_weight)
O cálculo é um ponto de partida, não uma regra universal. Pesos muito altos podem deixar o treinamento instável e aumentar falsos positivos. É necessário observar as métricas de cada classe e experimentar alternativas como amostragem, focal loss ou limites para os pesos.
No meu caderno, escrevi uma frase para não esquecer: desbalanceamento não é apenas um problema da perda; é um problema da avaliação. Mesmo usando pesos, eu ainda precisaria verificar se havia positivos suficientes na validação e apresentar intervalos de confiança em um estudo mais rigoroso.
Também é importante calcular pos_weight apenas com o treino. Usar a distribuição da validação ou do teste para tomar essa decisão mistura informações entre as etapas do experimento.
Quinta-feira, 18/09/2026: finalmente escolhendo a rede
Em conjuntos pequenos, treinar uma CNN inteira do zero costuma ser difícil. Com transfer learning, começamos com representações aprendidas em um conjunto maior e adaptamos a última camada ao nosso problema.
Depois de passar alguns dias pensando nos dados, chegar à arquitetura foi quase anticlimático. Escolhi a ResNet18 porque ela é simples o bastante para servir como baseline, possui pesos pré-treinados e permite iterar sem transformar cada experimento em uma espera longa.
1
2
3
4
5
6
import torch.nn as nn
from torchvision.models import ResNet18_Weights, resnet18

model = resnet18(weights=ResNet18_Weights.DEFAULT)
model.fc = nn.Linear(model.fc.in_features, len(label_columns))
model = model.to(device)
Não colocamos sigmoid dentro do modelo porque BCEWithLogitsLoss já combina a operação com o cálculo da perda de forma numericamente mais estável.
Antes do treinamento, fixei as sementes. Isso não torna toda execução perfeitamente determinística em qualquer hardware, mas reduz uma fonte de variação e deixa explícita a intenção de reproduzir os resultados.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import random

import numpy as np
import torch


def seed_everything(seed=42):
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)


seed_everything()
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Dispositivo: {device}")
Um ciclo de treinamento mínimo fica assim:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
from torch.optim import AdamW

optimizer = AdamW(model.parameters(), lr=1e-4, weight_decay=1e-4)

for epoch in range(10):
    model.train()
    running_loss = 0.0

    for images, targets in train_loader:
        images = images.to(device)
        targets = targets.to(device)

        optimizer.zero_grad()
        logits = model(images)
        loss = criterion(logits, targets)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * images.size(0)

    train_loss = running_loss / len(train_loader.dataset)
    print(f"Época {epoch + 1}: loss={train_loss:.4f}")
Esse primeiro loop serve para testar se tudo está conectado, mas ainda não é o que eu queria guardar como experimento. Acrescentei uma função de validação e passei a salvar o estado com a menor perda:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
def validate(model, data_loader, criterion, device):
    model.eval()
    running_loss = 0.0
    targets_buffer = []
    probabilities_buffer = []

    with torch.no_grad():
        for images, targets in data_loader:
            images = images.to(device, non_blocking=True)
            targets = targets.to(device, non_blocking=True)

            logits = model(images)
            loss = criterion(logits, targets)

            running_loss += loss.item() * images.size(0)
            targets_buffer.append(targets.cpu())
            probabilities_buffer.append(torch.sigmoid(logits).cpu())

    return {
        "loss": running_loss / len(data_loader.dataset),
        "targets": torch.cat(targets_buffer).numpy(),
        "probabilities": torch.cat(probabilities_buffer).numpy(),
    }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
best_valid_loss = float("inf")
Path("checkpoints").mkdir(parents=True, exist_ok=True)

for epoch in range(10):
    model.train()
    running_loss = 0.0

    for images, targets in train_loader:
        images = images.to(device, non_blocking=True)
        targets = targets.to(device, non_blocking=True)

        optimizer.zero_grad(set_to_none=True)
        logits = model(images)
        loss = criterion(logits, targets)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * images.size(0)

    train_loss = running_loss / len(train_loader.dataset)
    validation = validate(model, valid_loader, criterion, device)

    print(
        f"Época {epoch + 1:02d} | "
        f"treino={train_loss:.4f} | "
        f"validação={validation['loss']:.4f}"
    )

    if validation["loss"] < best_valid_loss:
        best_valid_loss = validation["loss"]
        torch.save(
            {
                "model_state_dict": model.state_dict(),
                "optimizer_state_dict": optimizer.state_dict(),
                "labels": label_columns,
                "epoch": epoch + 1,
            },
            "checkpoints/best-resnet18.pt",
        )
O checkpoint guarda mais do que os pesos porque eu quero saber qual ordem de rótulos foi usada e em que momento o modelo foi salvo. Ainda faltariam as versões das bibliotecas, os hiperparâmetros e o identificador da divisão dos dados para uma rastreabilidade melhor.
Sexta-feira, 19/09/2026: os resultados
Antes de calcular novas métricas, voltei aos resultados publicados no experimento que usei como referência. A CNN simples foi treinada por 25 épocas. O registro numérico mostra loss=0,5352, accuracy=0,522 e ROC-AUC=0,4867 na primeira época; na segunda, loss=0,4899, accuracy=0,562 e ROC-AUC=0,5037. Ao final, foram reportados aproximadamente loss=0,45, accuracy=0,53 e ROC-AUC=0,66.
Nos gráficos de loss e acurácia abaixo aparecem apenas as épocas que possuem valores numéricos informados na referência. A linha conecta esses pontos para facilitar a leitura, mas não representa medições inventadas para as épocas intermediárias.
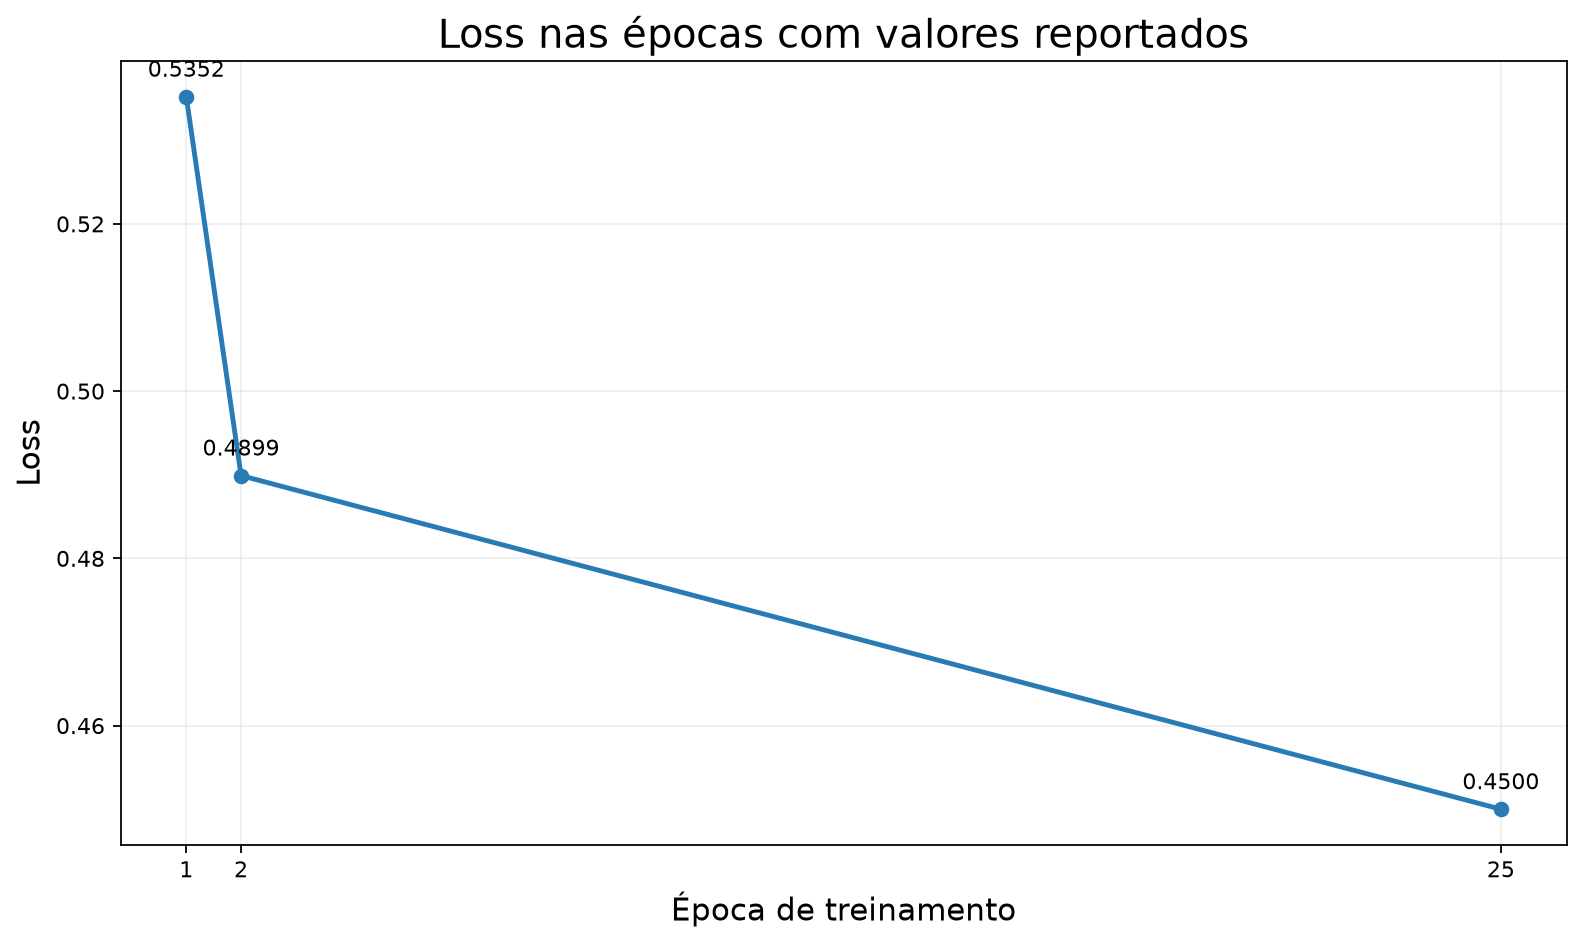 Figura 3: loss reportado para as épocas 1, 2 e 25 da CNN.
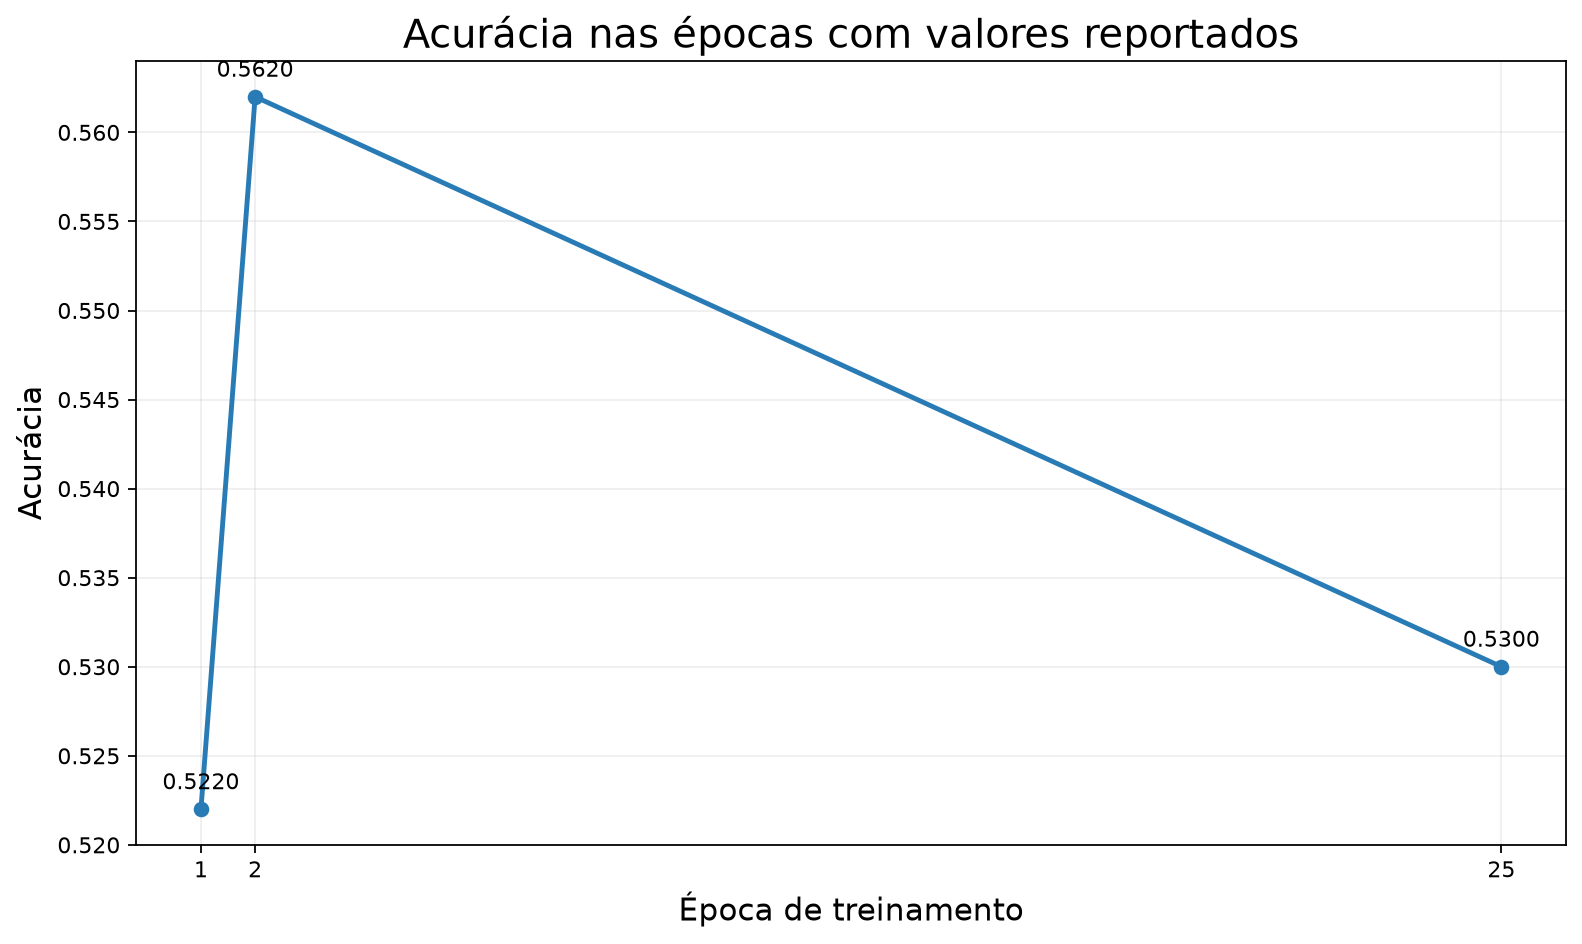 Figura 4: acurácia reportada para as épocas 1, 2 e 25 da CNN.
A referência também apresenta a curva completa do ROC-AUC médio. Ela mostra uma melhora geral ao longo das 25 épocas, embora existam oscilações consideráveis durante o treinamento.
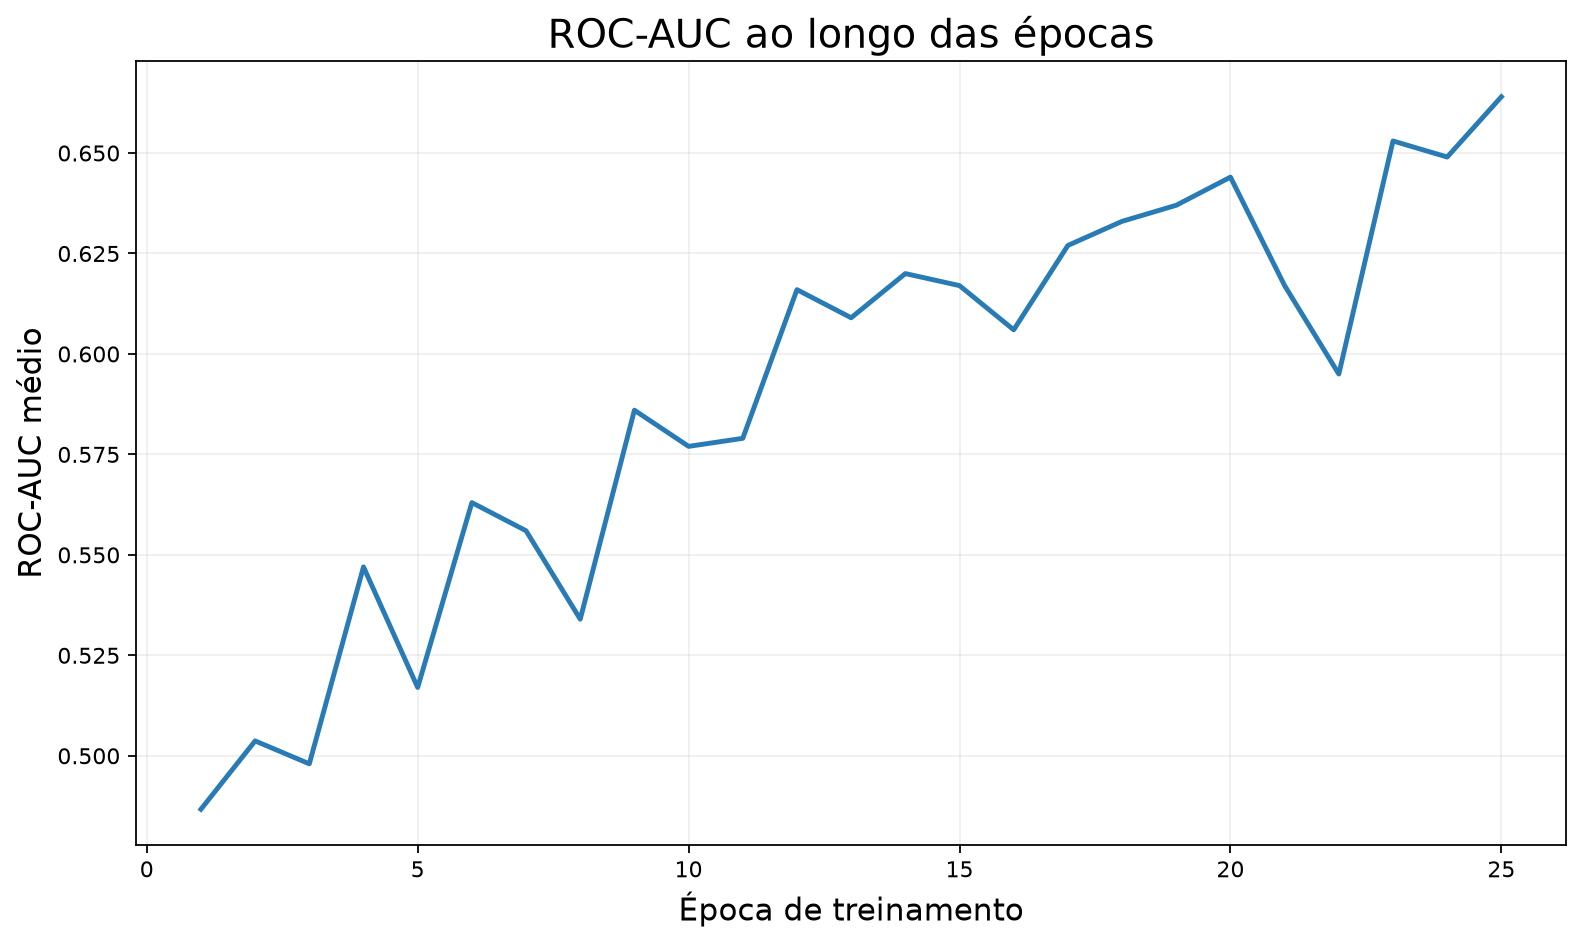 Figura 5: evolução do ROC-AUC apresentada no experimento de referência, encerrando em aproximadamente 0,66.
Quando a arquitetura foi substituída por uma ResNet18 pré-treinada, os valores finais reportados melhoraram para loss=0,12, accuracy=0,77 e ROC-AUC=0,98.
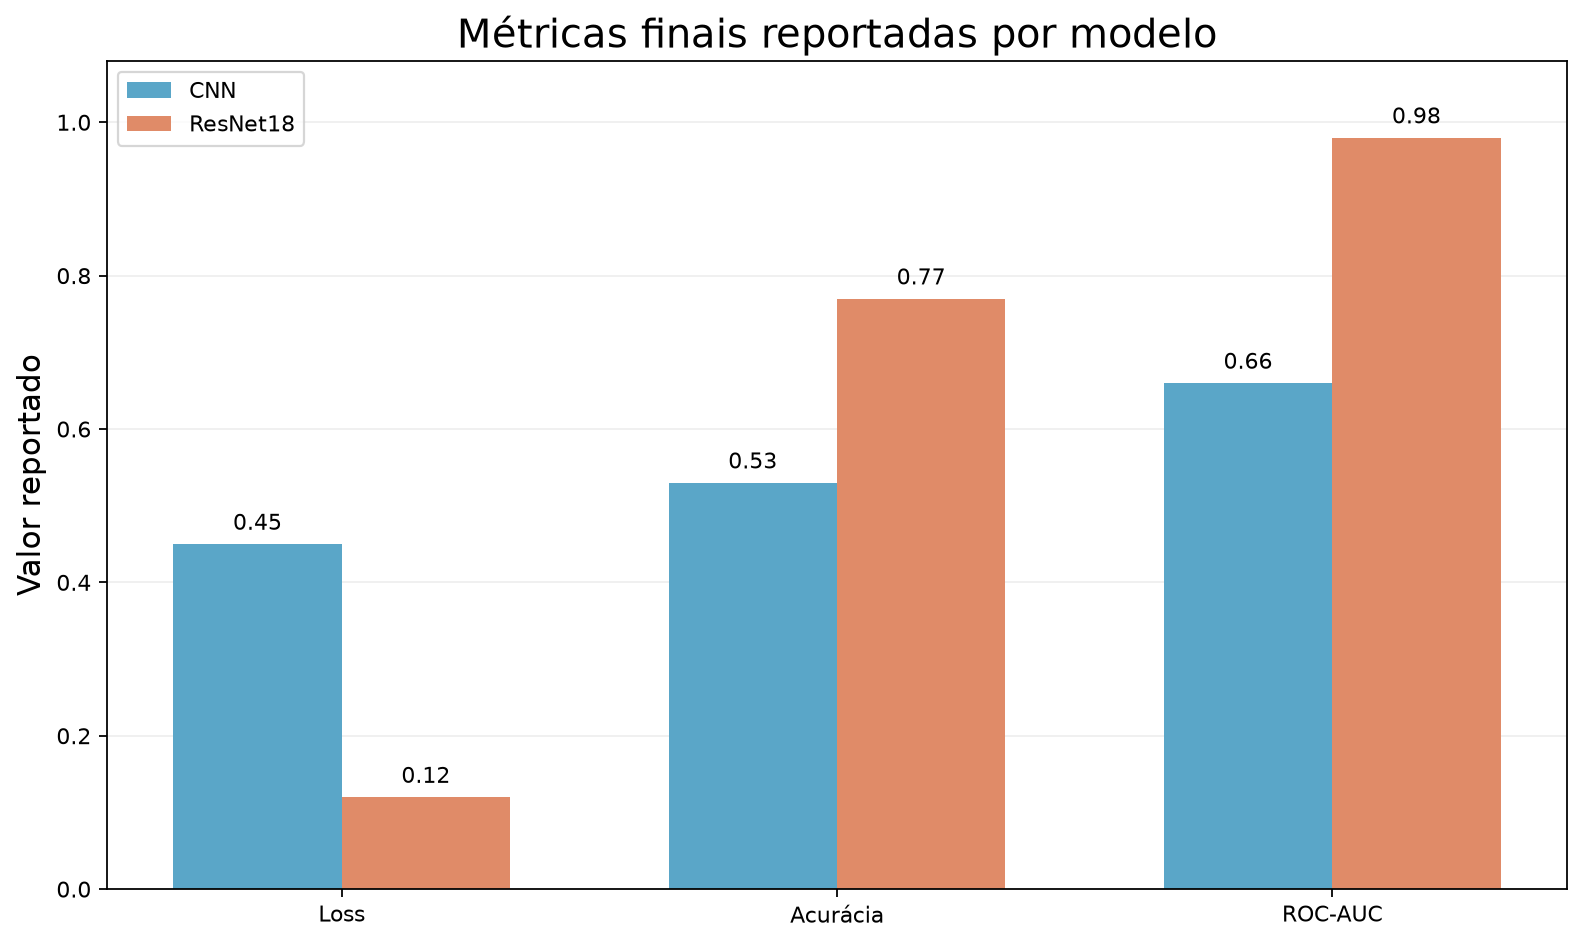 Figura 6: comparação dos valores finais reportados para a CNN simples e a ResNet18.
Esse salto é interessante, mas precisa ser interpretado com cuidado. As métricas foram calculadas durante o treinamento e não substituem uma avaliação independente nos conjuntos de validação e teste. Um ROC-AUC alto no treino mostra que o modelo se ajustou aos dados vistos; sozinho, ele não demonstra generalização para novos pacientes.
Para cada patologia, queremos observar pelo menos:
- Sensibilidade (recall): entre os casos positivos, quantos foram encontrados?
- Especificidade: entre os casos negativos, quantos foram descartados corretamente?
- Precisão: entre os alertas emitidos, quantos eram positivos?
- ROC-AUC: o quanto o modelo ordena positivos acima de negativos em diferentes limiares?
- PR-AUC: como precisão e recall se comportam, sendo especialmente informativa em classes raras?
Primeiro coletamos as probabilidades no conjunto de validação:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import numpy as np

model.eval()
all_targets = []
all_probabilities = []

with torch.no_grad():
    for images, targets in valid_loader:
        logits = model(images.to(device))
        probabilities = torch.sigmoid(logits).cpu().numpy()

        all_probabilities.append(probabilities)
        all_targets.append(targets.numpy())

y_true = np.concatenate(all_targets)
y_prob = np.concatenate(all_probabilities)
Depois calculamos as métricas separadamente. Uma média única pode esconder que o modelo funciona bem para condições frequentes e falha justamente nas raras.
1
2
3
4
5
6
7
8
9
10
11
12
13
from sklearn.metrics import average_precision_score, roc_auc_score

for index, label in enumerate(label_columns):
    targets = y_true[:, index]
    probabilities = y_prob[:, index]

    if len(np.unique(targets)) < 2:
        print(f"{label}: sem positivos ou negativos suficientes")
        continue

    roc_auc = roc_auc_score(targets, probabilities)
    pr_auc = average_precision_score(targets, probabilities)
    print(f"{label}: ROC-AUC={roc_auc:.3f} | PR-AUC={pr_auc:.3f}")
Aqui tive outra mudança de perspectiva: uma métrica não é apenas um número para colocar no final do post. Ela é uma lente. ROC-AUC, PR-AUC, sensibilidade e especificidade mostram comportamentos diferentes. Se eu olhar apenas para uma delas, posso construir uma narrativa confortável e incompleta.
Para enxergar o comportamento de cada classe, eu organizaria os resultados em uma tabela e compararia a PR-AUC com a prevalência. Em uma classe rara, a prevalência funciona como um baseline simples para interpretar a curva de precisão e recall.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
metrics = []

for index, label in enumerate(label_columns):
    targets = y_true[:, index]
    probabilities = y_prob[:, index]

    if len(np.unique(targets)) < 2:
        continue

    metrics.append({
        "patologia": label,
        "positivos": int(targets.sum()),
        "prevalencia": float(targets.mean()),
        "roc_auc": roc_auc_score(targets, probabilities),
        "pr_auc": average_precision_score(targets, probabilities),
    })

metrics_df = pd.DataFrame(metrics).sort_values("pr_auc", ascending=False)
print(metrics_df.round(3))
O limiar de 0,5 não é uma lei
A saída do modelo é contínua, mas em algum momento precisamos decidir quando uma patologia será considerada presente. Usar 0,5 para todas as classes é conveniente, porém raramente é a melhor decisão.
O limiar depende do objetivo. Em uma ferramenta de triagem, pode fazer sentido privilegiar sensibilidade, aceitando mais falsos positivos para reduzir o risco de deixar um caso importante passar. Em outro fluxo, excesso de alertas pode sobrecarregar a equipe e exigir um equilíbrio diferente.
Os limiares devem ser escolhidos somente com o conjunto de validação. Depois de definidos, são avaliados uma única vez no conjunto de teste. Ajustar o limiar olhando o teste é outra forma de vazamento.
1
2
3
4
5
6
7
8
9
10
11
12
from sklearn.metrics import precision_recall_curve


def threshold_for_recall(y_true, y_score, minimum_recall=0.90):
    precision, recall, thresholds = precision_recall_curve(y_true, y_score)
    valid = np.where(recall[:-1] >= minimum_recall)[0]

    if len(valid) == 0:
        return 0.5

    best = valid[np.argmax(precision[valid])]
    return float(thresholds[best])
Não existe um “melhor limiar” independente do contexto. Existe uma escolha alinhada a um uso, um custo de erro e uma população.
Minha etapa seguinte: abrir os erros
Depois das métricas, eu não encerraria o notebook. Separaria os falsos negativos e falsos positivos de cada patologia e voltaria às imagens. O objetivo não seria diagnosticar visualmente os casos, mas procurar padrões técnicos:
- exames com contraste muito diferente;
- imagens portáteis ou com enquadramento incomum;
- presença de artefatos, textos ou dispositivos;
- rótulos possivelmente inconsistentes;
- grupos de pacientes nos quais o erro se concentra.
Esse passo também pode revelar shortcuts: pistas correlacionadas ao rótulo, mas que não representam a condição. Se uma classe aparece mais em exames feitos por determinado equipamento, o modelo pode aprender o equipamento em vez da patologia.
Eu registraria cada hipótese sem tratá-la imediatamente como conclusão. Em projetos desse tipo, é muito fácil olhar uma visualização, encontrar uma história plausível e confundir plausibilidade com evidência.
Sábado, 20/09/2026: tudo o que este projeto ainda não responde
Mesmo um pipeline tecnicamente correto deixa perguntas importantes em aberto:
- Os rótulos representam consenso entre especialistas ou foram extraídos automaticamente de laudos?
- O desempenho muda conforme idade, sexo, origem ou equipamento utilizado?
- O modelo usa sinais da anatomia ou atalhos presentes na imagem?
- As probabilidades são bem calibradas?
- O modelo mantém o desempenho em outro hospital?
- Como os erros afetam o fluxo de trabalho de profissionais e pacientes?
Também precisamos de análise de erro. Vale inspecionar falsos positivos e falsos negativos, comparar o modelo com baselines simples e usar técnicas de interpretação com cautela. Um mapa de calor visualmente convincente não prova que o raciocínio do modelo é clinicamente válido.
Ao final dessa etapa, minha lista de pendências ficou maior do que no começo. Curiosamente, isso não me pareceu um fracasso. Significava que eu estava começando a enxergar o problema para além da API do PyTorch.
Para transformar este estudo em um experimento mais completo, meus próximos passos seriam:
- Documentar a origem e a qualidade dos rótulos
- Criar um conjunto de teste isolado por paciente
- Comparar ResNet18 com um baseline simples
- Medir calibração das probabilidades
- Calcular incerteza das métricas com bootstrap
- Avaliar subgrupos e possíveis vieses
- Testar generalização em uma fonte externa
- Revisar as decisões com alguém da área clínica
Fechando o caderno por enquanto
Construir uma ResNet para radiografias de tórax é relativamente direto. Construir um experimento em que as métricas mereçam confiança é a parte difícil.
As decisões mais importantes acontecem ao redor da rede: formular corretamente a tarefa, separar pacientes, entender como os rótulos foram produzidos, lidar com classes raras, escolher métricas adequadas e testar generalização. A arquitetura é importante, mas não consegue corrigir um problema mal definido ou dados contaminados.
Esse é um dos aspectos que mais me interessam na interseção entre IA e saúde. Não basta fazer o código rodar ou obter um número alto. Precisamos entender o que o modelo aprendeu, onde ele falha e em quais condições podemos confiar no resultado.
Comecei este estudo querendo praticar redes convolucionais. Terminei com muito mais perguntas sobre dados, validação e responsabilidade do que sobre convoluções. Talvez esse tenha sido o resultado mais importante até aqui.
Por enquanto, o caderno fica aberto. Quero voltar a este projeto depois de executar os experimentos, comparar os baselines e substituir as ilustrações de métricas por resultados reais, acompanhados das condições em que foram obtidos. A parte interessante não é chegar rapidamente a uma resposta; é construir uma resposta que sobreviva às perguntas difíceis.